GPU и AI
Вычислительные ускорители и инфраструктура вокруг них: чем обучение больших моделей отличается от инференса по требованиям к видеопамяти и межкарточной шине, как считать питание и охлаждение стойки, что даёт связность узлов и когда имеет смысл смотреть на альтернативные платформы вместо привычного вендора. Материалы для тех, кто собирает вычислительный кластер и хочет считать стоимость владения, а не только цену карты.
Все статьиGPU и AIЭкологияРоботыМашиностроениеПроизводствоМатериалы и сырьёВидеоконференцсвязьОборудование Hasivo
Как проверяем ускорители NVIDIA перед отгрузкой партии
GPU и AI
MetaXLink или Ethernet — как масштабировать пул ускорителей
GPU и AI
Воздушное или жидкостное охлаждение MetaX C600 — что выбрать
GPU и AI
Перенос обучения и инференса на MetaX MXMACA — что проверить заранее
GPU и AI
Сколько видеопамяти нужно ускорителю под вашу модель
GPU и AI
На что влияет сеть между узлами GPU-кластера при обучении
GPU и AI
 Как проверить совместимость ускорителя NVIDIA с серверной платформой
GPU и AI
 Что считать при расчёте питания и охлаждения стойки под ускорители
GPU и AI
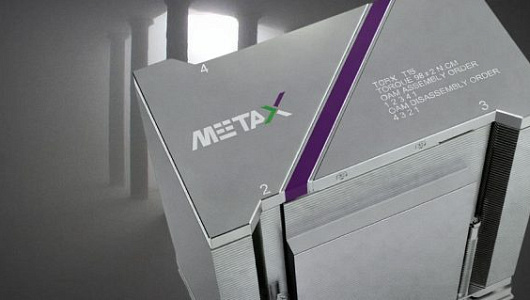 MetaX C588 или C600 — что даёт масштабирование до 256 карт
GPU и AI
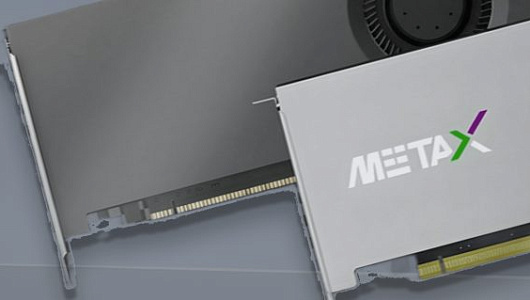 Как выбрать конфигурацию MetaX C500 или C500X под задачу
GPU и AI
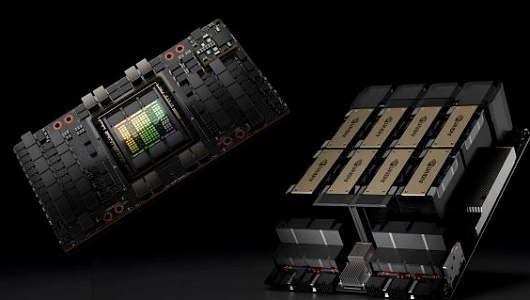 Как выбрать между NVIDIA H200 и H100 для обучения модели
GPU и AI
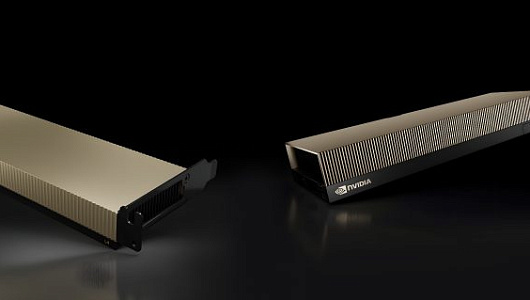 NVIDIA L40S или L4 — что взять под инференс и видеоаналитику
GPU и AI
Как проверить совместимость ускорителя NVIDIA с серверной платформой
GPU и AI
Что считать при расчёте питания и охлаждения стойки под ускорители
GPU и AI
MetaX C588 или C600 — что даёт масштабирование до 256 карт
GPU и AI
Как выбрать конфигурацию MetaX C500 или C500X под задачу
GPU и AI
Как выбрать между NVIDIA H200 и H100 для обучения модели
GPU и AI
NVIDIA L40S или L4 — что взять под инференс и видеоаналитику
GPU и AI
